

Synthetic Clinical Trial Data Market Size, Share, and Industry Trends Forecast 2026-2036
Synthetic Clinical Trial Data Market Insights
Modular bundling of synthetic data engines with electronic health record platforms is expanding buyer choice across the clinical research stack. MDClone leverages its health system partnerships to anchor deployment within integrated delivery networks. Syntegra sustains R&D intensity through specialized generative models for structured clinical tabular data. Amazon Web Services competes by embedding synthetic data pipelines within its cloud-native healthcare architecture, reducing friction for pharmaceutical clients.
Synthetic clinical trial data comprises algorithmically generated patient records that replicate statistical distributions, correlations, and temporal patterns found in real-world clinical datasets without containing identifiable individual information. These datasets typically preserve multivariate relationships across hundreds of clinical variables while satisfying differential privacy thresholds, enabling their use in protocol simulation, control arm modeling, and regulatory submission support. Imaging Data and Genetic Data segments command premium positioning due to the computational complexity of generating high-fidelity radiological sequences and variant-level genomic profiles. Drug Development applications dominate current procurement volumes, though Algorithm Training for AI diagnostic tools represents the fastest-expanding use case as developers seek compliant alternatives to restricted real-world datasets.
FDA guidance on real-world evidence and the EU AI Act's risk-classification framework for clinical decision support systems are reshaping product standards and procurement criteria across North America and Europe. HIPAA constraints on patient data sharing in the United States and GDPR anonymization thresholds in Europe create parallel compliance obligations that synthetic data vendors must engineer around. Stakeholders should monitor how regulators reconcile synthetic data utility with evolving evidentiary standards for regulatory submissions.
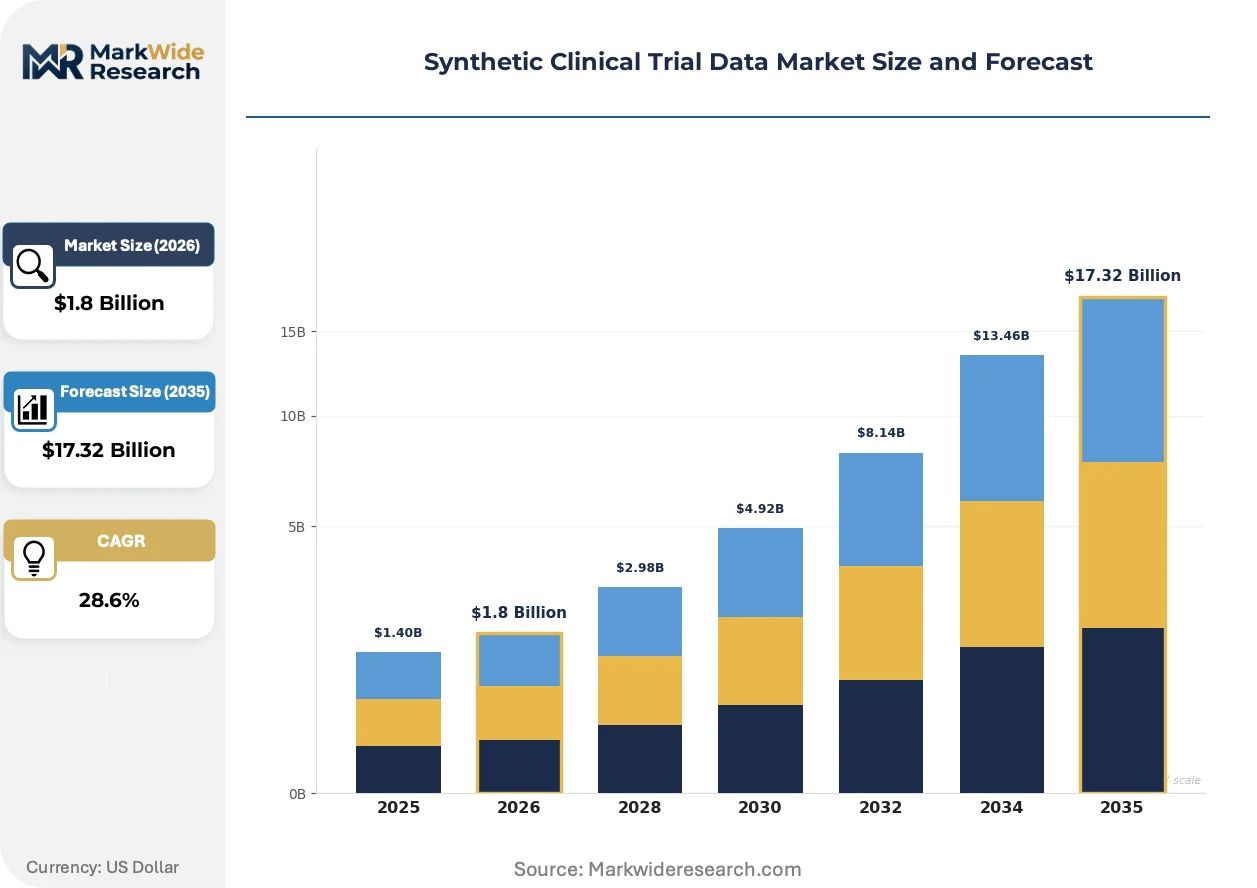
Market Dynamics
Pharmaceutical procurement patterns are shifting decisively toward modular integration of synthetic data engines within existing clinical analytics infrastructure, compressing standalone vendor margins while elevating platform-native providers.
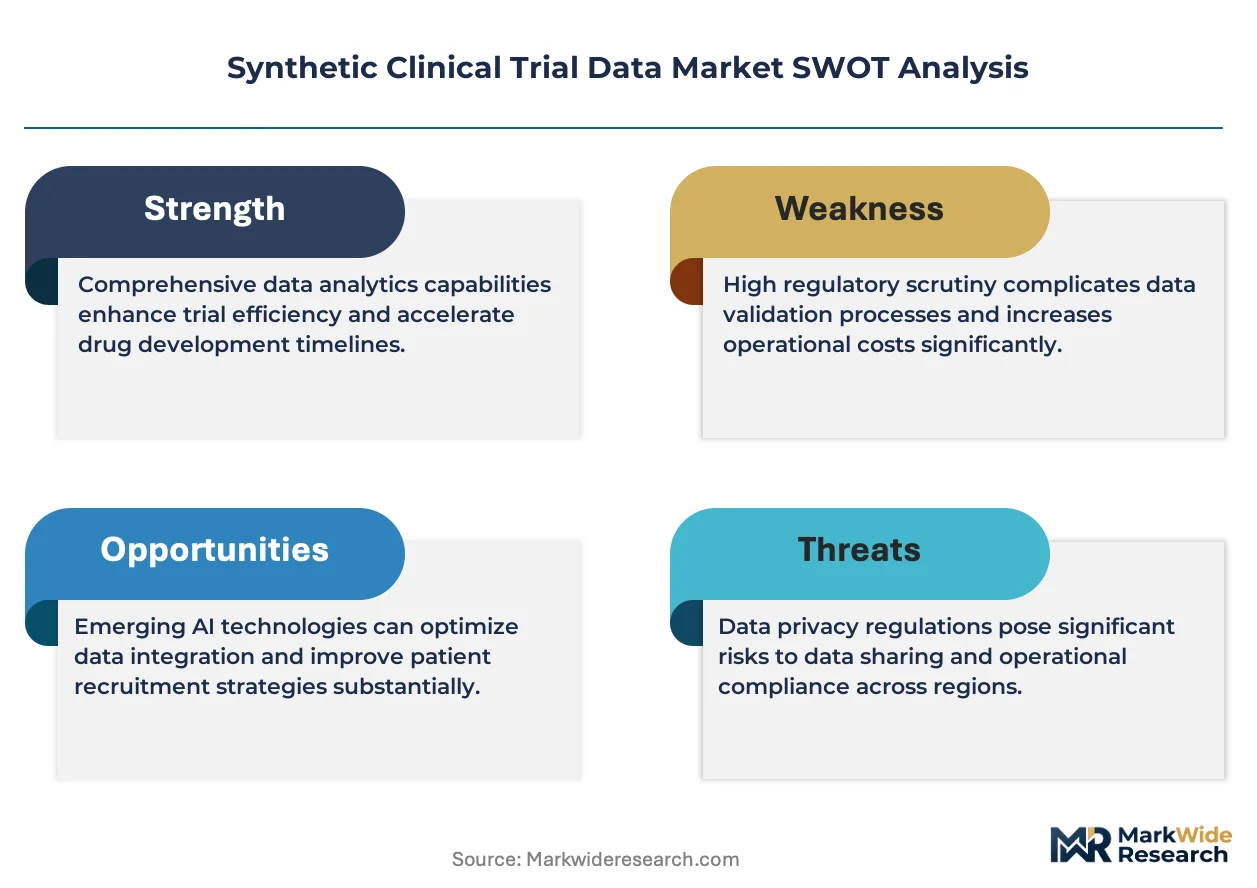
Growth Catalysts
- FDA real-world evidence framework:The agency's expanded acceptance of algorithmically derived control arms accelerates sponsor investment in synthetic cohort generation for rare-disease protocols.
- EU AI Act risk classification:High-risk clinical decision support systems face mandatory training data documentation, driving demand for privacy-preserving synthetic alternatives to restricted patient records.
- Generative adversarial networks for imaging:GAN architectures capable of producing DICOM-compliant radiological sequences unlock synthetic data applications in oncology trial simulation previously blocked by data scarcity.
Market Restraints
- Computational infrastructure costs:Training foundation models for high-fidelity genomic variant simulation requires GPU clusters whose capital intensity excludes mid-tier CROs.
- Regulatory evidentiary uncertainty:Divergent FDA and EMA positions on synthetic data utility for primary endpoints create submission risk that sponsors price into procurement decisions.
- Validation protocol immaturity:Absence of standardized metrics for fidelity assessment forces buyers to commission bespoke verification studies, extending sales cycles.
Strategic Opportunities
- Japan's PMDA digital transformation:The regulator's pilot program for AI-enabled drug development tools creates first-mover advantage for synthetic data vendors establishing local validation partnerships.
- Federated learning convergence:Integration of differential privacy synthetic generation with federated analytics architectures enables multi-site trials without centralizing sensitive patient data.
- Algorithm training for diagnostic AI:Developers of radiology and pathology classifiers seek compliant alternatives to biobank-restricted datasets, opening a high-margin application segment.
Industry Challenges
- Biostatistical talent scarcity:Synthetic data validation requires expertise spanning both generative modeling and clinical epidemiology, a combination concentrated at a handful of academic medical centers.
- Legacy EHR integration friction:Health system IT architectures built around Epic and Cerner impose data format constraints that complicate synthetic engine deployment.
Report Scope
MarkWide ResearchGet the full picture before you read further.
Download a free sample with table of contents, companies, segments, and methodology.
Synthetic Clinical Trial Data Market Trends and Innovations
Generative modeling architectures are compressing the fidelity gap between synthetic and real-world clinical records, while regulatory frameworks crystallize around privacy-preserving alternatives to traditional data sharing.
Diffusion models for structured clinical tabular data are absorbing the methodological complexity previously handled by variational autoencoders in patient record generation. Large pharmaceutical sponsors and academic research networks are adopting these architectures for protocol simulation within twelve-month procurement cycles. The technology is absorbing engineering talent from adjacent natural language processing teams, consolidating methodological leadership among vendors with pre-existing transformer expertise.
The EU AI Act's risk-based classification system for clinical decision support systems imposes mandatory training data governance documentation on high-risk applications. This regulatory architecture forces synthetic data providers to engineer audit trails and provenance tracking into their generation pipelines. Oncology and cardiovascular diagnostic AI developers in Germany and France are restructuring procurement criteria to prioritize vendors with pre-validated compliance packages.
Pharmaceutical buyers are consolidating vendor relationships around platform-integrated synthetic data modules rather than standalone tools. Contract research organizations are disintermediating pure-play synthetic data vendors by building in-house generation capabilities atop cloud partnerships. This pattern concentrates procurement volume with health systems and CROs possessing existing cloud-native infrastructure, most visibly across Massachusetts and North Carolina research clusters.
Synthetic Clinical Trial Data Market Segmentation
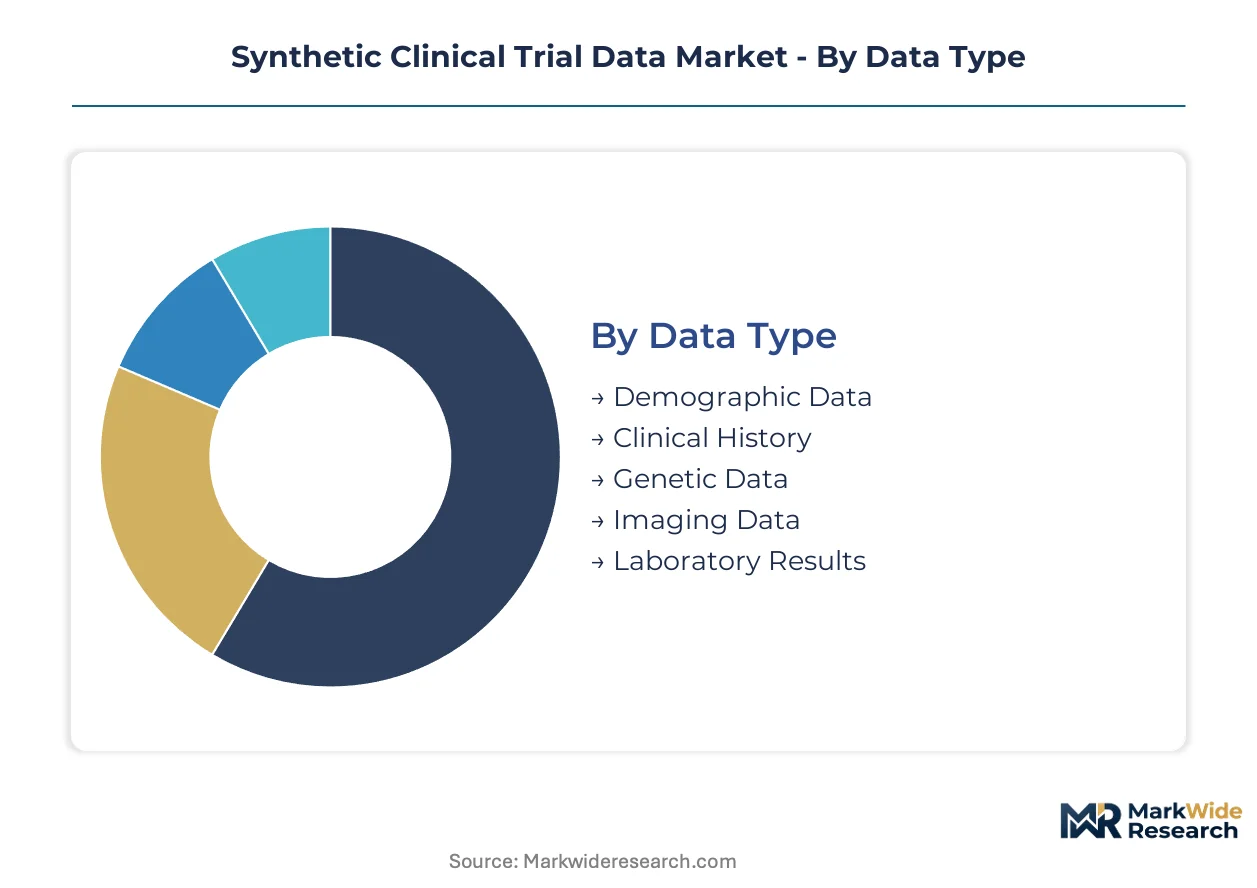
Synthetic clinical trial data vendors configure their generative engines around distinct data architectures, each imposing unique computational constraints and regulatory validation requirements. Procurement decisions across pharmaceutical sponsors hinge on which segment combinations satisfy protocol-specific fidelity thresholds while navigating HIPAA and GDPR anonymization mandates.
Data Type:
Pharmaceutical buyers differentiate primarily by the multivariate complexity each data type demands from generative models.
- Imaging Data:DICOM-compliant radiological sequences require GAN architectures with 3D convolutional layers to preserve spatial anatomical relationships. Demand concentrates in oncology trial simulation across Massachusetts research clusters, where sponsors seek alternatives to biobank-restricted CT and MRI datasets for control arm modeling.
- Genetic Data:Variant-level genomic profiles necessitate foundation models trained on population-scale allele frequency distributions. Procurement from rare-disease specialists in North Carolina accelerates as FDA guidance expands acceptance of algorithmically derived control arms.
- Clinical History:Longitudinal patient records spanning diagnoses, procedures, and medications.
- Demographic Data:Age, sex, ethnicity distributions stratified by disease prevalence.
- Laboratory Results:Structured biomarker panels and pathology reports.
Volume sits with Clinical History; growth tilts toward Imaging Data.
Source:
Data provenance determines synthetic fidelity benchmarks and integration friction with existing clinical analytics infrastructure.
- Electronic Health Records:Epic and Cerner system extractions impose format normalization challenges that elevate engineering costs. Health systems in California and Texas anchor deployment within integrated delivery networks, prioritizing vendors with pre-built EHR connectors.
- Genomic Databases:Controlled-access repositories like dbGaP and UK Biobank supply training distributions for variant simulation. EU AI Act documentation requirements reshape procurement criteria among German diagnostic AI developers seeking compliant alternatives.
- Patient Registries:Disease-specific cohorts with standardized outcome definitions.
- Claims Data:Administrative billing records capturing utilization patterns.
- Sensor Data:Continuous physiological monitoring from wearables and implantables.
Procurement concentrates on Electronic Health Records; expansion is steepest for Genomic Databases.
Application:
Regulatory evidentiary standards vary sharply across use cases, compressing margins in mature segments while opening premium pricing in emerging validation categories.
- Drug Development:Protocol simulation and control arm modeling for rare-disease trials absorb the majority of sponsor investment. FDA real-world evidence framework accelerates procurement from sponsors seeking to supplement underpowered comparator arms in orphan indications.
- Algorithm Training:Radiology and pathology classifiers demand high-fidelity synthetic datasets to circumvent biobank restrictions. Developers in France and Germany restructure vendor selection around EU AI Act risk-classification compliance packages.
- Medical Device Testing:Performance validation for AI-enabled diagnostic tools.
- Data Privacy Enhancement:Differential privacy overlays for sensitive cohort sharing.
- Simulation Studies:Virtual patient recruitment and trial outcome prediction.
Revenue clusters in Drug Development; Algorithm Training gains share fastest.
End User:
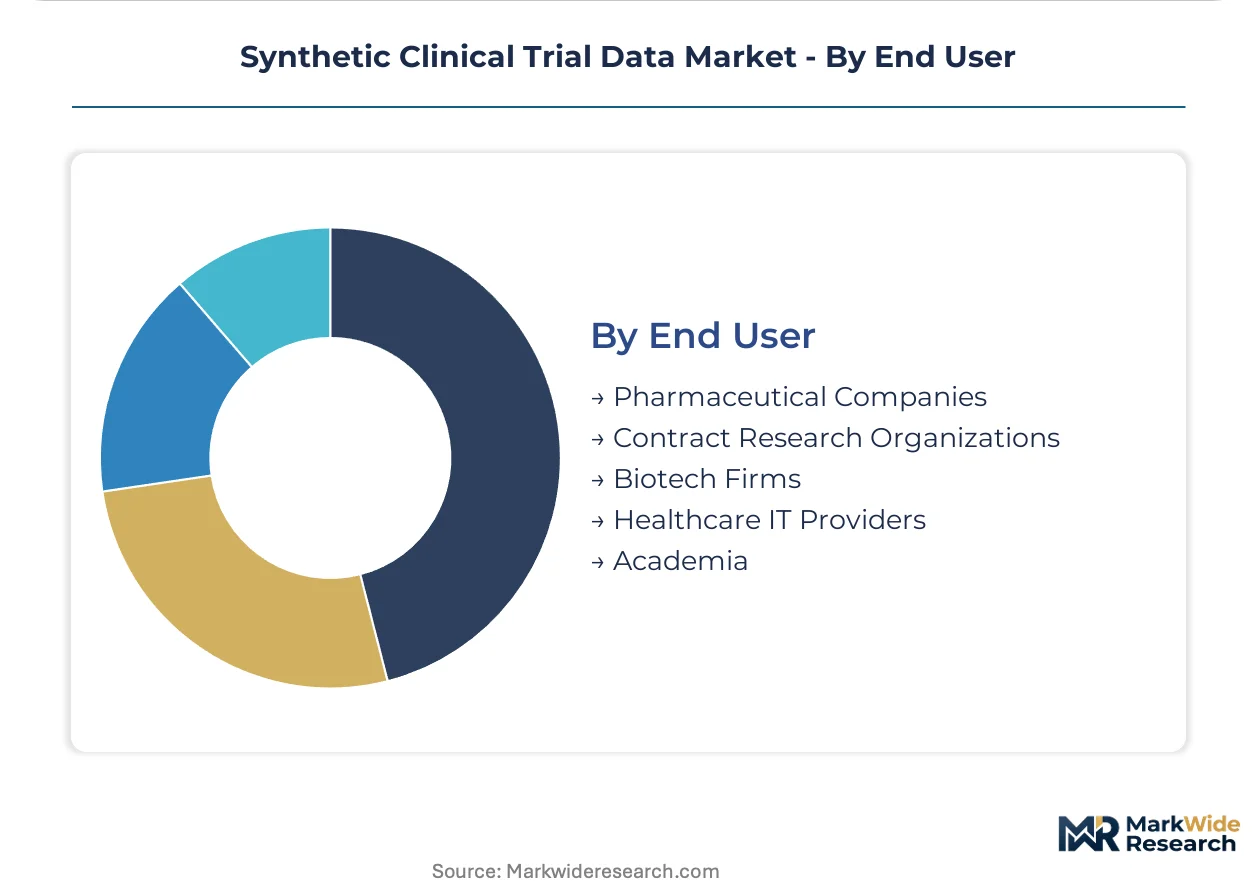
Organizational scale and cloud-native maturity dictate synthetic data deployment architecture preferences.
- Pharmaceutical Companies:Top-20 sponsors consolidate procurement around platform-integrated modules within broader clinical analytics suites. Internal biostatistics teams commission bespoke validation studies, extending sales cycles but commanding premium pricing for proven fidelity.
- Contract Research Organizations:Mid-tier CROs disintermediate pure-play vendors by building in-house generation capabilities atop AWS and Azure partnerships. North Carolina and Massachusetts clusters concentrate this self-sourcing trend.
- Biotech Firms:Venture-backed developers with limited biostatistical staffing.
- Healthcare IT Providers:EHR platform vendors embedding synthetic engines as native features.
- Academia:Research networks with federated analytics requirements.
Spending dominance rests with Pharmaceutical Companies; Contract Research Organizations expand most quickly.
Need this report tailored to your region?
Request specific countries, segments, or companies — tailored to your requirements.
Regional Outlook
Research Triangle Park in North Carolina and Kendall Square in Massachusetts function as tax-advantaged innovation zones concentrating synthetic data R&D. FDA real-world evidence guidance and EU AI Act compliance mandates reshape procurement across pharmaceutical clusters.
United States
FDA draft guidance on AI-enabled medical devices accelerates sponsor investment in synthetic cohort generation. HIPAA constraints on patient data sharing force vendors to engineer differential privacy thresholds into generation pipelines. Massachusetts and North Carolina research clusters concentrate pilot programs for rare-disease trial simulation.
Germany
EU AI Act risk-classification requirements for clinical decision support systems drive mandatory training data documentation. EMA positions on synthetic data utility for regulatory submissions create evidentiary standards that reshape vendor selection. Munich and Heidelberg diagnostic AI developers prioritize pre-validated compliance packages in procurement.
United Kingdom
NHS data-sharing restrictions and UK Biobank access protocols elevate demand for privacy-preserving alternatives. GDPR anonymization thresholds intersect with MHRA guidance on real-world evidence. London and Cambridge health tech clusters anchor deployment within integrated delivery networks.
Japan
PMDA pilot programs for AI-enabled drug development tools create first-mover opportunities for validation partnerships. METI digital health initiatives subsidize synthetic data infrastructure for domestic pharmaceutical sponsors. Tokyo and Osaka research consortia test federated learning architectures with differential privacy overlays.
France
ANSM and CNIL joint guidance on health data anonymization establishes compliance benchmarks for synthetic generation. EU AI Act documentation requirements reshape procurement criteria among Paris and Lyon diagnostic AI developers. Gustave Roussy and Institut Curie anchor oncology trial simulation demand.
Synthetic Clinical Trial Data Market Competitive Landscape
Diversified conglomerates compete with focused pure-play specialists across modular integration and standalone deployment vectors. Cloud-native platform providers embed synthetic engines within broader healthcare architectures, compressing margins for independent vendors. Three archetypes dominate: health system-anchored specialists, cloud-integrated technology platforms, and biostatistical service hybrids. M&A activity concentrates on validation protocol acquisitions, while strategic partnerships target EHR connector development.
Among health system-anchored specialists, MDClone and Syntegra exemplify the integrated deployment model. AWS occupies a position within the cloud-native tier, embedding synthetic pipelines within pharmaceutical client architectures. These three anchors represent divergent strategic bets on whether synthetic data procurement consolidates around platform integration or preserves standalone specialist viability.
| Leading Market Players |
|---|
| MDClone |
| Syntegra |
| Syntho |
| Hazy |
| Datavant |
| Truveta |
| HealthVerity |
| Microsoft |
| Amazon Web Services |
| Others |
Pricing and Supply Chain Analysis
GPU cluster procurement costs cascade from hyperscaler infrastructure through synthetic data vendor pricing tiers, compressing margins for standalone specialists while elevating platform-native providers with captive compute access.
Pricing Analysis
Margin tightening in mid-tier synthetic data services reflects pharmaceutical sponsor consolidation around bundled analytics suites. Three-tier pricing structure across premium, standard, and economy levels stratifies by validation protocol depth and regulatory submission support. Premium tiers command pricing power through FDA pre-validation packages, while economy tiers face acute price sensitivity from biotech firms with limited biostatistical staffing. Cost-down pressure on standalone vendors accelerates as contract research organizations build in-house generation capabilities atop cloud partnerships.
Supply Chain Analysis
Returns and refurbishment flows for decommissioned GPU hardware from hyperscaler data centers in the United States, Taiwan, and Ireland feed secondary markets serving mid-tier synthetic data vendors. Raw material dependencies span advanced semiconductor lithography equipment, high-bandwidth memory modules, and specialized cooling systems. Single-source vulnerability concentrates in NVIDIA accelerator supply, with distribution running through direct hyperscaler partnerships and authorized reseller channels for enterprise clients.
Get the full picture before you read further.
Download a free sample with table of contents, companies, segments, and methodology.
Analyst Recommendations
Synthetic clinical trial data procurement is consolidating into a vertical-integration race, with platform-native providers capturing margin by embedding generation engines within broader clinical analytics infrastructure.
For Market Incumbents: Deploy validation protocol acquisitions to anchor differentiation against cloud-native entrants. Deepen health system partnerships to secure EHR connector exclusivity before Cerner and Epic finalize native synthetic data modules. Acquire biostatistical talent concentrated at Massachusetts and North Carolina academic medical centers to defend premium pricing tiers. For New Entrants and Emerging Players: Enter via algorithm training for diagnostic AI applications, where EU AI Act documentation requirements create compliance-driven demand unmet by incumbents. Target French and German radiology classifier developers seeking pre-validated privacy-preserving alternatives to biobank-restricted datasets. Pursue strategic partnerships with federated learning consortiums to bypass capital-intensive GPU cluster requirements. For Investors and Strategic Acquirers: FDA draft guidance expansion on algorithmically derived control arms is the leading indicator that rare-disease synthetic cohort generation will consolidate procurement volume among validation-proven vendors. Target acquisition archetypes combine generative modeling IP with established health system deployment footprints. Monitor Japan PMDA pilot program outcomes for early signals of regulatory acceptance divergence.| Strategic Initiative | Industry Significance |
|---|---|
| Platform Integration with EHR Systems | Epic and Cerner native embedding captures procurement volume from health system IT budgets. |
| Validation Protocol Acquisition | FDA pre-validated compliance packages command premium pricing from pharmaceutical sponsors. |
| Federated Learning Architecture Development | Differential privacy overlays enable multi-site trials without centralizing sensitive patient data. |
| GPU Cluster Partnership with Hyperscalers | AWS and Azure infrastructure access reduces capital intensity for mid-tier vendors. |
| Regulatory Submission Support Service | EMA and FDA evidentiary guidance expertise differentiates vendors in control arm modeling. |
Research Methodology
Multi-period observation of synthetic data procurement patterns, regulatory guidance evolution, and vendor partnership announcements anchored the trend analysis, supplemented by interviews with pharmaceutical biostatistics directors, health system CIOs, contract research organization procurement leads, and regulatory affairs specialists at FDA and EMA. Secondary validation drew from FDA guidance documents, EU AI Act implementation texts, ClinicalTrials.gov protocol registrations, and hyperscaler healthcare vertical disclosures. Bottom-up vendor revenue estimates triangulated against top-down pharmaceutical R&D spending allocations.
Input-output matrices mapped generative model deployment scale to pharmaceutical sponsor segmentation across data type, application, and end-user categories. CAGRs derived from regression analysis of procurement volume indicators against regulatory acceptance milestones, with segmentation dimensions spanning imaging versus genetic versus clinical history data types, drug development versus algorithm training applications, and pharmaceutical company versus CRO versus biotech end-user archetypes. Forecast inputs incorporated GPU infrastructure cost trajectories and differential privacy threshold engineering requirements.
Forecast precision tightens around the base case; tail outcomes carry wider variance under divergent FDA-EMA regulatory acceptance scenarios and hyperscaler pricing policy shifts. Practitioners should monitor Japan PMDA pilot program results and EU AI Act enforcement patterns for early signals of validation protocol standardization.
Need Custom Data?
Can't find what you're looking for? Our analysts can build a custom report tailored to your exact requirements.
1,000+
Global Clients
150+
Countries Covered
65,000+
Reports Available
Frequently Asked Questions
Why Work With MWR
Trusted by 1,000+ businesses across 150+ countries for high-stakes market decisions.
Ready to access intelligence that moves business?
Browse Reports →Trusted by Global Leaders
From Fortune-level organizations to global SMEs, we provide intelligence for high-stakes decisions.
Multi-Language Support
Research available in French, German, Spanish, Chinese, and more.
ISO & IAF Certified
Globally aligned quality standards ensuring methodological discipline and data integrity.
Competitive Relevance
Free inclusion of 3–4 additional companies of your choice in every report.
Customized Insights
Tailored intelligence for market entry, niche expansion, or competitive benchmarking.
Post-Sale Assistance
Dedicated coordination to help interpret findings and address queries post-delivery.
Cutting-Edge Methods
Structured data collection, advanced analytics, and expert validation for reliable forecasts.
Value for Investment
Credible, structured intelligence at a cost that makes strategic sense.